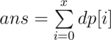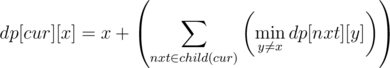顯示具有 String 標籤的文章。 顯示所有文章

2016年7月7日 星期四

Codeforces Education Round 1

經過N個月, 公司的Project 終於見到尾聲...趁住扮工時間的空閑, 隨便找了一下CF的比賽來玩

很久之前看到CF推出的Education Round 系列已經感到興趣, 決定玩下 Round 1

看名字覺得是for 新手學習用, 所以很想玩, 但竟然...此Round 無Editorial...

究竟無Editorial 點樣可以Educate到人呢 ?

Anyway 這場有A-F共6題, 難度我覺得也是D2至D1尾吧? 最後AC了5題, 最後一題有點想法但Code不出來

要說學習了什麼, 倒不如說溫故知新, 特別是問了Peter神及GG 一些埋藏多年的白痴問題

Codeforces Education Round 1


A: (Math)

題目就不詳說了。
數據很小, 題目也很直觀, 基本有bitwise operation的底子可以直接code出來。
要是沒有的話其實暴試, repeat squaring之類的 怎樣也能AC。

B: (String, Ad-hoc, STL)

這題是Given 一條 string S, 然後 有一堆range query [l_i, r_i] 及T , 代表在這個range (inclusive) 內的substring 要向右rotate (shift ) T 次.

老實說這條應該是想最久的吧...因為比題目結構嚇倒了, 直接想到什麼range query什麼segment tree都出來了。

結果第二天扮工時間再看題目, 發現數據根本很小, 直接暴力做就可以了...

當然T 可以很大, 但由於 rotate 多過range的長度等於重置一次, 直接T%L (L = r_i - l_i + 1) 就好了。

我是用最慢但應該最易看的白痴寫法: C++的 STL, substr() 了很多次, 左拆右拆的, 一樣能AC。

只是看了Peter神跟 Gary神的 Code, 他們都不需要用C++的東西, 有點慚愧...

D: (Graph: DFS)

容我先跳過C, 因為題C數據上是最少人AC的, 我也最後才做, 也是相對學習得較多的一題。

題目很有趣, Given 一個2D Grid,  每格可以是路, 可以是牆。 如果是牆的話上面會有名畫一張。 然後Given m 個起始位置, 問如果你由該位置開始一直行, 怎樣行都可以 (除了穿牆), 你總共能看到多少名畫。

這樣想吧, 其實連續起來的路是一個component, Grid入面就有數個disjoint 既 components, 每個component入面不論那點作為開始, 看到的數量也是一樣的。

每個component 就像是圍棋內的一塊棋, 他們的「氣」就是名畫的數量

扯遠了...其實沒什麼關係XD

所以做法很簡單, 直接DFS, 把每個位置都歸入某個component內, 順便計算該component能看到的名畫數量。如果某點已經知道屬於那個component, 那便不用再花時間DFS了, 直接output 答案便可。 每個格子能看到的名畫數量可以在DFS前先計算好。

思路不難想, 算是鬥快寫DFS吧?

AC Code: http://www.codeforces.com/contest/598/submission/18879479


E: (DP)

這題老實說, 對我來講算是開始有難度了...雖然我知還是很簡單的題目。

題目是這樣的:  有朱古力一條, 有N*M 格,  現在你可以拆斷它, 但一定要直線或橫線, 整數地拆。每拆一次 cost 為該線的square, 問如果你想要exactly k 格朱古力, 最少cost 的拆法要多少

這類題目我有陰影, 總是想起從前有條POJ 好像叫Stick的題目, 當年覺得完全沒有思路, 不可能做得出, 然後Leo好像淡淡說了句: 呢條唔係Search ja咩? 

自那時起我都以為Search是一類特別的題目Category...
其實到現在也不太清楚他講乜春, 但這條的確是Searching, 雖然實作上是用DP做啦 (可以這樣說吧?)

數據很小, 其實也明顯是要你直接用DP做的了, 數據小到DP的方法也很直接

DP(N, M, K) :=  Minimum Cost to get K chocolates out of N*M one

DP(N, M, K)  = Min ( DP(N_1, M, K_1) + DP(N_2, M, K_2) + M*M,   DP(N, M_1, K_1) + DP(N, M_2, K_2) + N*N) for all N_1+N_2 = N, M_1+M_2 = M, K_1+K_2 = K

說白了, 就是每條邊, 和K的每種可能性 (K=4的話, 左邊0粒, 右邊4粒 / 左邊1粒, 右邊3粒...)都試掉, 看那種最優。

Code是不難寫的, base case小心點處理就好了。我是用Top-Down的寫法, Peter 神是用Bottom-Up的, 分別也不太大。

唯一WA了一棍...是被白痴位陰掉了...他有很大量的Query數目...但其實DP State pre-compute一次就行了, 第一棍把DP 放進 Input Query 的loop 裡了, 吃了TLE。

要說這條的學習, 我總是在想要是數據再大一點, 不能直接DP時, 會不會有其它做法, 這個還未有答案。

另外就是我對於分析這種Recursion + Memorization 的Complexity 很弱, 完全不知怎樣分析, master theorem好像也不能apply, 當然靠經驗感覺我知道肯定不會TLE, 但從來不知道正確及General的分析方法, 究竟是Big-O of 什麼。

有關這個, 我在Stack Overflow上問了一下, 好像也沒什麼特別的答案
http://stackoverflow.com/questions/38215549/how-to-analysis-the-time-complexity-of-this-code/38240874?noredirect=1#comment63937690_38240874

倒是Peter神的想法是把DP state的tree 做一次DFS, 所以是O(|V|+|E|), 然後看題目決定|V|和|E|是什麼, 這個想法當然好, 但我不肯定是不是General所有DP 的solution都可以這樣想, anyway仿然要#Adore#一下

C: (Geom)

最後解到的這題, 只有63個人AC了的這題, 其實不難理解。

題目本身不算難...但是一碰到Geom, 就一定會弄到精度問題, WA也不為過 

我沒有為自己WA了 13棍而開脫。

好吧先說題目 :)

題目是Given 10^5 個 vector, 全部連住Origin的。問那兩支vector的角是最小的, 這裡說的角沒有方向, 總之是該兩支vector的+角或-角magnitude 最小的 就ok。可以print出任何答案。

話說這樣的數據量, 基本上是要O( N lg(N) )的了, 看完題目基本就是Sort by Angle了吧

印象中Sort by Angle有兩種方法做, 但我只記得一種: 用atan2() 來sort.

當然n年沒有code過 geom題目的我, 一定要google atan2的用法...那些就不說了 :(

題解就是sort 完, 然後每一支vector跟前一支 (或後一支) 計一下角度, 然後找最minimum 那一pair 就好了 (最minimum 那一pair 在sort 完後一定是相鄰的, 對吧?) 

小心最後一支也要跟第一支比較。

問題來了, 一直WA一直WA, 完全不知錯在那裡。看完TEST CASE更加相信是精度問題...

所以這題的99%難度在精度問題。 以往我只知道要用eps, 但怎樣用, 為何要這樣用我也忘光了。所以我發射飛彈, 試了eps 由  e-6 開始到e-18 都試過了, 全部都WA....

終於最後, 忍不住, 隨手打開第一名那個的Code看...根本與我沒分別...唯一的分別, 在於他是用long double, 我是用double!!!!

我改完之後, 果然AC了.....!

究竟何時要用long double, 何時要用double? 我也不知道, 這是一個謎...

另外之後我問了GG, 究竟何時要用eps,  現在有一個更好的concept了....

原來eps的原意是比較2個double variable是否一樣, 而當你想 differentiate 它們的時候, 就要用上eps 來比較 ( <= 或 >= ). 在這題中用不上, 因為我們只考慮角度, 有些題目可能也要考慮長度, 那麼可能就有分別了 (sort by 角度, 角度一樣不等於"一樣")

而eps 通常是set e-8, 是-8,  至於為什麼, 連GG也說不知道 =.=


F: (Geom?)(最後一題的思路有時間後補吧...)

回到家打果然比在公司偷偷打要好得多。

這題的題目光用看的也感受到變態程度, 直到現在更只有 2個人AC...

題目大意是Given 一個 N-Side polygon, 可以Concave, Input格式為N 點, 點可以同線。
然後Given 一堆query, 每個query 是一條線, (可能) intercept with this polygon.
問, 在這條線在polygon 內的總長度是多少?

好吧我的確沒什麼完整的思路, 但腦海中立即出現的是當年CSC326 學的 Ray-Casting Algorithm (好像是叫這名字?)

好像是Given一點, 向住某一條線"射"出去, 看看穿過多少條polygon的邊。按照單雙數, 可以得知該點是否在Polygon內。

或許當中有某些思路可以apply? 沒什麼方向。 結論是為何Education Round沒有Editorial??


PS (Bonus)

雖然很慢, 但有感覺自己一直在進步, 可能一些以前沒有學懂的現在都會主動去學而且大約都能學會。但實在是不夠時間用, 在教會也開始要幫忙作鼓手跟導師, 工作上也愈來愈忙 (雖然快將轉工了應該), 加上要做Gym還有一大堆聚會要去, 有種感覺是一天24小時真的太少了....

另外之前在FB 路過看到一條好像是數學Olympic的題目, 對於0數學底的我, 也有些想法, 跟Peter神討論了一下, 可惜還是沒有答案~


以下是完全沒有數學底子 我的想法, 正確答案在Facebook 這幅圖的top comment已經有了 (按照那個like的數目來看)  好像是用一些我看不明白的number theory 的argument

所以這兒的想法只是自己的FF

首先證明 y = x^3 + 37 (mod 3)

By Fermat's Little's Theorem, y^2 = 1 (mod 3), So L.H.S. = y^2 ... y^2 * y (mod 3) =  y (mod 3)
R.H.S. = x^3 + 37 (mod 3),  So  y = x^3 + 37 (mod 3), Q.E.D.

然後下面是一些完全9 up 的東西, 是關於Chinese Remainder Theorem的。
從 Wiki 可以看到,

Suppose n1, ..., nk are positive integers that are pairwise coprime. Then, for any given sequence of integers a1, ..., ak, there exists an integer x solving the following system of simultaneous congruences.

這兒我重點關注 any sequence of integers a_i 這句。
我想, 這是不是等同說明

Given y = x^3 + 37 (mod 3)
There Exist some a' = x^3 + 37 (mod 5)  such that 
 y = a' (mod 5) 

因為 3 跟 5是co-prime嘛, 然後x^3 + 37 也肯定是integer for any x
同理 其它 prime number 也跟 3 是 co-prime, 所以 y = x^3 + 37 (mod p) 

然後L.H.S 跟R.H.S. 一同自乘 37次 就行了...


但這只是我的狂想, 因為我根本不了解Chinese Remainder Theorem, 特別是我覺得以上的argument 有違
A solution x exists if and only if
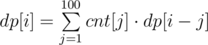
所以也就沒再深究下去了。(後註: 後來想下去果然還是錯得很離譜XD)

2015年5月25日 星期一

Google Code Jam 2015 Round 1C

終於有心情打最後一篇今年的GCJ文

話說幾經辛苦把這場的solution都看完再把題目都AC之後

發現這場真的遺憾 還記得只要我做到 C-Small 就能Advance了

而C-Small (甚至C-Large) 在看完solution後驚覺是很易的...是應該能做到的

這兒學習到一件事, 要正視自己一直以來其中一個思考的弱點..下面再說

至於B-Large 是絕對不可惜, 甚至我也是在昨天才勉強明白solution的方法

只能說我的Probability / Expected Value學得太差了...

總結來說, 這場比1B學得更多, Ad-hoc度雖然也很高, 但仍然是有學習的地方

即場時我AC了 整題的A跟B-Small, 其它都是事後再AC的

玩了3場的GCJ Round 1, 我認為心理跟策略上也是有改善的空間

Google Code Jam 2015 Round 1C


A: (Ad-hoc, Greedy)

這題是我唯一能整題過的題目...
就結果來說, 其實Small的思路跟Large的是完全一樣
但即場由於策略問題, 完全沒多加思考Large 就跑去看B跟C了...
弄得同一樣的Code, 卻過了一小時才交A-Large...

題目本身很易嗎? 也不算, 也不是難...是很伏
很明顯很容易想少一些Case的類型

題目是這樣的:

給了一個R*C的Grid, 你跟你弟弟要玩一個遊戲.
你弟弟會放一隻 1*x  (打橫長x格) 的船在任意位置
你要做的就是猜船的位置, 並且把他打沉 (你看不到船的位置)
打沉的方法是: 把船的 x 格佔有位置都說出來

問題是你知道弟弟會出cheat, 他可以任意移動船的位置, 
只要跟你所知道的情報沒有矛盾就可以了
例如: 你說了某一格的位置, 弟弟可以先把船移動, 然後跟你說"沒有中"
當然, 當某一格他說了沒有中 (或中了) 之後, 那一個的狀態就不能再改變了
不然就跟你所知的情報有矛盾了

問題問, 你先走, 在知道弟弟會盡可能地出cheat的情況下, 你最少要用多少步才能勝出?

Small Case是Large的引導版, 是只有一個Row的 (R*C, R = 1)
我是先把想法大概猜到了, 才開始做個簡單的證明的

思路大約是: 由於最少都要用X做答案, 每次弟弟出Cheat會把答案的次數增大1
所以盡量減少他可以出Cheat的次數...對這個是可以控制到的, 因為他不能與我所得的情報相矛盾

怎樣可以限制弟弟出Cheat的次數呢? 不難聯想到跟Greedy有點關係
"盡可能"選擇某些位置使他不能出很多次Cheat這樣

答案就是: 由左至右, 每次選第 x 格
如果弟弟說了"中"的話, 基本最多再選 x 次就完結了 (為什麼不是x - 1次是伏位, 下面再說)
但弟弟這樣說沒好處, 如果他還能出Cheat的話
但他要再出Cheat, 就只能把船向右移了 (如果本身是選中了的話)
那麼我就再一次選向右的第x格...如此類推

那麼弟弟已經走投無路, 所有左邊的位置都比我"封鎖"了
他被迫要說"中了"
那麼我們就限定了那一格是船的某一部分
但伏位是...很自然會以為那格是船的 "最右點"
但這未必是真的,  要是 C 本身不能被X整除, 那麼其實右邊還有空間再移動
只是不夠整架船移動 (再出Cheat)

所以要是你用x - 2 步把船的 x - 2格都猜中了
第 x - 1 步, 弟弟永遠都可以說你錯了, 他可以出最後一次Cheat把船向相反方向移動一格
浪費你多一步 所以要是 C本身不能被 X 整除的話, 答案還要另外 + 1

這基本就是Small的答案了

而Large呢, 首先發現, 每一Row都是獨立的, 可以分開來看
Greedy地選也完全沒問題
所以就把這個策略重複 R-1 次, 最後一個Row就當是Small一樣的做法就好了...

策略上...我應該先花幾花鐘想想Small是否能改一下就能交Large的...
這題根本不用花一小時再交...

#include<bits/stdc++.h>
#define LL long long
#define PI acos(-1)
#define x first
#define y second
#define PII pair<int,int>
#define F(x,y,z) for(int (x)=(y);(x)<(z);(x)++)
#define pb push_back
#define mp make_pair
#define eps 1e-7
#define feq(x,y) (fabs((x)-(y)) <= eps)
#define flt(x,y) ((x)+eps < (y))
#define fle(x,y) ((x)+eps <= (y))
#define fgt(x,y) ((x) > (y)+eps)
#define fge(x,y) ((x) >= (y)+eps)
using namespace std;

int T,n,r,c,w,ans;
int main(){
    scanf("%d", &T);
    for(int qwe=1; qwe<=T;qwe++){
        scanf("%d%d%d", &r,&c,&w);
        ans = (r-1)*(c/w);
        ans += (c - w)/w + w + (c%w != 0);

        printf("Case #%d: %d\n", qwe, ans);
    }
    return 0;
}

B: (String, Probability, Expected Value)

這題是這一Round最難的了 (如果考慮Large的話)
這題有我最苦手的Probability / Expected Value的問題...
幸好結果來說我有學到東西了...

題目有點複雜就不說了 直接說分析

Small是很簡單的Brute Force, 隨便寫Backtrack都可以

Large就需要數學技巧了...
首先題目有點賤
題目要找的是: Expected Number Of Banana Left 

首先我來說一下我對Expected Number 的理解:
很白痴, 我只懂最簡單的definition: Weighted Average of Possible Result
也就是 E(X) = P(a)*v(a) + P(b) * v(v) + ...
where P() 跟 v() 是 probability 跟 Value of 所有Possible outcomes

然後因為之前某場CF, 我也得知了一個經常會用到的Property叫
Linearity of Expectation
這個是這條題目的重點, 是很方便很強大的Property, 可惜我對他的理解等於零

在CF上面厚顏地開了Post求問, 有人給了一些很好的Reference, 看了之後才開始有點理解
http://codeforces.com/blog/entry/18025#comment-228851

這個Property, 引用Wiki的說法: 
\operatorname{E}[a X + b Y + c] = a \operatorname{E}[X] + b \operatorname{E}[Y] + c\,
即使 X , Y 是 dependent 的Random Variable!!

先不詳細說這個東西, 回到題目上面
設 C為你會準備的Maximum # of bananas, 
那麼題目就是求 E(X) = E(C - X)  = C - E(X)  where X  = expected # of bananas give out

那麼題目就分兩部分了: 找出C跟找出E(X)

先說找 C
首先跟KMP一樣, 要先找出Pattern 的"最長前後綴"
由於string很短, 不用failure function找也可以...直接substring()找就行了...
有了這個之後..就可以直接用String的長度 S
去算出所有可能性裡面包括最多Pattern的String究竟有多少個Pattern
是為C

重點還是要在算E(X)上面吧
首先說一下不懂答案思路之前的想法:
跟上面說的一樣, 我只會最基本的Definition
所以很自然就會去想 
E(X) = P(Exact 1 banana)*1 + P(Exact 2 bananas)*2 + ...
(詳情我CF那個Post有說, 可以自己去看)

但當然這樣算沒有好處, exact X banana這些event 明顯就不是independent的
無限double count, 也不知道怎用 (知道也不會用, 想也知難code) inclusion-exclusion principle
總之直感也知道不是這樣直接去數的, 用Counting之類的數法是不行的了

然後...答案竟然是很直接的...
設P 為 Pattern在某一個位置出現的機率, 這個易算, 直接用Product Rule乘起來就是了
然後重點是:
By Linearity Of Expectation, E(X) = P*(S-L+1) As there are (S-L+1) possible starting point for Pattern

這句是如何來的...!?
看了CF那個Post後...我終於有了以下的理解 (還不知道對不對, 最少我信了)

先說一下Random Variable
它們只是一些有不同值的Variable, 每個值都associate 一個probability, 當然加起來就是 1

視乎情況, 這些值可以自己define出來的, 最常見的就是 1 跟 0 (某些desire result就設1, with some probability P, otherwise 0 with (1-P))

由於他們是variable, 可以照樣自己設立一些equation

例如設 Z 為 # of bananas giving out, 我不知道Z 的所有Value跟它們的probability 
但照樣可以寫一個equation

Z = A_1 + A_2 + A_3...
A_i 是 # of banana when pattern start at position n

A_i 我們倒是知道的, 沒錯就是最常用的 {1 with some probability p, 0 otherwise}
這個 some probability p 就是solution中算的 P, 所有A_i 的 p 都是一樣的

現在不難發現A_i 互相也不是independent 的!
在某一個位置假設出現了pattern, 某些位置就不可能出現了...

這就是Linearity Of Expectation 發光的地方了!
\operatorname{E}[a X + b Y + c] = a \operatorname{E}[X] + b \operatorname{E}[Y] + c\,
即使 X , Y 是 dependent 的Random Variable!!

Z = A_1 + A_2 + A_3...
==>
E(Z) = E(A_1 + A_2 + ...) = E(A_1) + E(A_2) + ...
= P*1 + P*1 + ...
= P*(S-L+1)

嗚啊...即使不是Independent也還是可以直接這樣做, So 變態...
這個技巧不用真的很熟悉Probability...也可以照學起來吧, 思路而已...

這題做不到真的不可惜, 因為回頭看根本不是能做到的東東
還有要知道: 不恥下問真的很重要, CF真的是很好的平台 :)

PS: 最後糾結的是...比較 P 跟 0的時候 不知道為什麼不能用eps, 不是應該要用才對嗎? 用了反而會錯, sample case都過不了...eps這個東東也是要認真面對一下了

#include<bits/stdc++.h>
using namespace std;

int T, L,S,K;
int alphabet[300];
string kb, pat;
int main(){
    scanf("%d", &T);
    for(int qwe=1; qwe <= T; qwe++){
        scanf("%d%d%d", &K,&L,&S);
        cin>>kb>>pat;
        memset(alphabet,0,sizeof(alphabet));
        for(int i=0; i<K; i++) alphabet[kb[i]]++;

        // O = maximum overlap
        int O = 0;
        double maxBanana = 0, expectedBanana = 0, P_fixedPoint = 1;

        for(int i=0; i<L;i++) P_fixedPoint *= (alphabet[pat[i]]*1.0/K);

        if(P_fixedPoint > 0){
            for(int i=1; i<L; i++) if(pat.substr(0,i) == pat.substr(L-i)) O = i;

            maxBanana = 1.0 + (S-L)/(L-O);
            expectedBanana = P_fixedPoint * (S-L+1);
        }
        printf("Case #%d: %.8f\n", qwe, maxBanana - expectedBanana);
    }
    return 0;
}

C: (Ad-hoc, Greedy)

這題真的太太太可惜了...回頭看真的應該要做到的..

題目是說:
給了 D 種錢幣, 每種錢幣可以用C個, 現在要你合出 [1, V] 所有的value
當然有機會合不了, 所以你可以額外增加某一些種類的錢幣, 當然它們也只能用C個
問最少要另外增加多少種類的錢幣?

這兒我的思路, 一下子就飛去 Coin Change的 Classic DP去了
這個就是我開首說的壞習慣...
由Day 1 開始玩比賽到現在, 我每次看到題目有一點點像我聽過的Classic Problem
就會往那方向去想, 以為是一些簡單變種還是什麼
但其實by experience, 很多時候都是錯的...
有時候, 根本不用想那麼複雜(像這題)
有時候, 有一點點像, 但其實差很多很多 (特別是Graph類的題目)

總之這樣的"聯想式"的思考好像不太有效呢...很多時把自己帶進死胡同

這題結果也是這樣的, 其實跟Coin Change沒有關係...(當然如果會的話會有幫助)
整道題目只考你一個發現:

能合到的value像一條條segment, 是有range的

例如你不增加種類, 可能合到 [1,5], [10,12]....
這樣的話 其實 "6" 是一定要增加的了, 因為用現在所有種類都合不出來, 
也不可能用比6 大的種類合出來, 對吧?

這樣的話就是Greedy的想法了
我們想 maintain X, where X 是 最少的value such that [1,X] 都是你能合出來的
那麼X+1怎樣合出來呢?
可以試用 現在的種類(如果有還沒用的話)試試合不合到
不能的話只能增加合成種類
當X >= V 的時候 算法就完成了

When we add a new denomination X to S, the new set of values we could produce include each of the values we could produce with the existing set S plus between 0 and C of the new denomination X. If X is at most N+1, then this new set of values will be the set of all values from 0 to N+X*C, so we can update N to N+X*C.

這段借用solution的解說, 說明了增加/ 使用某一種類的錢幣時, 可以很簡單直接地update X (solution的notation跟我用的有不用, 注意一下)

由於只有D種現有錢幣, 而增加種類即使 X 變為 X+C*(X+1) = X(C+1) +C
C最少是 1 , 所以 X 最少是2倍2倍地增長, 直到 V, 最多就是O(lg V) 次

TOTAL = O(D + lg V) 的LOOP

這樣的分析..跟Facebook Hacker Cup 某題有點像, 也是不用嚴格地分析, 只要證明了
最少是2倍2倍地增加/減少, 就可以得出 O(lg X)的bound, 用來說服自己很有用

說起來, 這題的難度全部在於發現如何update X, 分析複雜度
至於Greedy地增加種類..是很直接的, 當時我是這樣猜, 但不能很系統地說服自己Greedy是正確的, 結果根本就是很明顯嘛...

int T,n,c,d,v,ans;
LL up, used, D[105];
int main(){
    scanf("%d", &T);
    for(int qwe=1; qwe<=T;qwe++){
        used = up = ans = 0;
        scanf("%d%d%d", &c,&d,&v);
        F(i,0,d) scanf("%lld", &D[i]);
        sort(D,D+d);
        while(up < v){
            LL X = up+1;
            if(used < d && D[used] <= X){
                up+= c*D[used++];
            }
            else{
                up += c*X; ans++;
            }
        }

        printf("Case #%d: %d\n", qwe, ans);
    }
    return 0;
}


終於終於 都把GCJ Round 1 的東東都搞完了...
剩下的就是String的文章, 還有Kattis那邊的"Lecture"吧?
String也是我拖太久 看到題B要用到的時候我已經打了自己兩巴 ...
(雖然根本重點在Expected Value)

GCJ, 下年再見吧 :/

2015年5月3日 星期日

Codeforces Round #300


先來兩張圖:


久別的參賽...這是一場 Div 2 + Div 1一起玩的比賽....
誘因是前300名有機會有T-Shirt...才厚臉皮參加的

運氣使然下, 結果比想像中好太多了...
雖然只做了最簡單, Div 2水平的4題 (共8題題目)
Room中竟然也排第6 
Rating也+158..差一點就變黃色User了=.=

興奮開心過後, 還是要面對一些問題:
首先頭4題一棍AC是高興的, 但除了D之外其實是很簡單的Div 2題目
D也不算難..但我認為之前的我未必能做到就是了...

而E 跟 F 才是真正的考驗, AC人數很合理的Div 1水平...
我認為要在比賽中能AC 這2題 其中1題才能算是Div 1吧...
這2題賽後幾經辛苦下也AC了...雖然還有些疑問
這場的Editorial 這2題寫得很亂..基本還是要自己想, 外加Peter神秒殺後也給了一點hints之類
過了之後在Editorial也試著把自己的想法留了comment, 題 E也有幾個正評, 太好了

至於G跟H 果斷放棄, 賽中不過100人能提交...賽後看Editorial也看不懂
暫時先放棄

結論: 先集中記下 題A-F好了

Codeforces Round #300


A: (Ad-hoc, String)

很基本的String題目, 就是問把一個substring移除後, 可以把string 變成 "CODEFORCES"嗎?

B: (Greedy)

這題可以秒殺是因為跟我曾經答過的Stack Overflow題目很像...
題目給了一個數字(n <= 10^6), 問把它拆成sum of Quasi Binary, 最少需要拆多少個?
Quasi Binary的定義是數字只由0或1組成: 10001, 10101, 10000...etc

先看Stack Overflow的題目: (shole是我在SO的名字)
Logic: Applying gravity to a vector


I think it is as simple as counting the total '1' bit of each position...
我這句也完全能apply在這題呢! 基本上就是每個digit 要不是0的話就是 >= 1, 還可以 (需要) 拆多一個Quasi Binary而在該位置也是1...然後原數字的該digit 就減1, 如此類推直到原數字變成0就好了

這題好像有人用很強的DP做...我是完全不知道怎樣用DP做的

C: (Math, Greedy)

題目給了n pair 數字 <a_i, b_i>
a_i 代表日子, b_i 代表高度
每日與隔日(前後一日)的高度最多能相差1
在給定了的n pair 數字和要符合這個條件下
最高的高度可以是多少? 要是本身 n pair 的input 不合理則說"IMPOSSIBLE"

n pair數字把日子分隔了n+1段
每段各自求最高的高度就可以了...
由於要符合條件, 最高的高度是能直接算出的
在紙上算了算...我好像寫了一條formula 出來
直接把 第 x日跟第y日之間的最大高度算出 (第x日的高度與第y日的高度沒有限制, 可以是h_x > h_y 或 h_x <= h_y)
   LL k = (h[i+1] + d[i+1] + d[i] - h[i])/2;
h 跟 d 是高度跟 日子

每一段都算一下取maximum的高度, 頭尾兩段特別處理就好了
O(n)的Greedy算法完成

算高度那一段有人用binary search做的 (好似係)

D: (Brute Force)

這題是賽中最後做到的一題了...話說本來連這題也苦無對策的
在AC之後才覺得這題其實很直接啊...證明以前水平太低了-.-

題目給了一個棋盤 棋盤上有棋數隻 (同一種類的)
然後mark了 那些位置是能被某些棋"吃掉"的
棋子自己的位置 可以是被"吃掉" 可以沒被"吃掉"

然後問: 這類棋子的移動方式怎樣? (可吃掉的位置)
要是有多種答案隨便輸出即可
(詳細要看輸入輸出例子, 自己按link看吧)

這類題目....除了暴試我也沒其它想法了
題目數據最大也是O(n^4) , 絕對是叫你暴試的

但開頭的想法怎樣也要O(n^5), 所以也想放棄了...
然後逆轉思維的時間到了..其實是在看例題輸出的時候想到的

題目input是 n*n 的棋盤 (n <= 50)
而output 是 2*n-1 * 2*n-1的棋盤...而棋子是在這兒的中間

如果我不是 "for 每隻在input的棋, for 每一格看看是不是由這隻棋吃掉.. for..." 這樣傻的想法
而是從output來想, "output的每一格, 與正中央(棋子)的 delta x, delta y 是已知的, for 每一格 O(100^2) , 看看input 的每一隻棋 O(50^2) 的delta x, delta y 位置是不是能吃掉 (或者另一隻棋或者out of bound)"

這樣的話是 O(2*2*50^4) = O(n^4)! 很像樣了, 正確性我認為也是self-explain! 也很好code!
太好了....回頭再想為什麼這樣暴試會快一點, 是因為output 限制了一隻棋能吃掉的range...
這樣其實不用每隻棋把全範圍試了...

Editorial好像不是這樣試的, 但comment中有一個很多正評的做法是這樣
Editorial也有一個挑戰: 用O(n^2 lg n) 解決同一問題...很變態的挑戰=.=


E: (DP on Tree, Graph)

終於到這一題了...賽後檢討的一題
很難很難, 我認為絕對是 Div 1的題目
而且下次再出現這樣的題目我也應該不懂=.=

題目很直接是DP on Tree的了, 由於每個state只會做一次, 基本上也可以用DFS代替

由於我花了一段篇幅在Editorial的comment寫了這題的思路, 就不詳細說了
http://codeforces.com/blog/entry/17612#comment-225396


這題印象最深的是...DP min 跟DP max 這2個state的轉移方式可以完全不同...
以前直覺上是相差不遠的
而這題完全經過一些很變態的分析之後, 發現一個的轉移是 summation(), 另一個是maximum()
太變態了...
把DP的答案強硬地控制在 [1, # of leaf under this node] 這個狀態定義也很變態

終歸一句: 這題學習到的是 DP的彈性真的很大...不聰明地分析根本不可能做到的吧...

F: (Data Structure Usage, BIT, Segment Tree, Math)

另一題變態的題目...
這題也有點故事的...話說有2個approach
一個是O(n lg^2 n)的, 另一個是 O(n sqrt(n))
我本身的想法是第一個approach which is 正確的想法

但那一個approach 以我的想法來說
是要用某些data structure(我認為BIT/ Segment Tree都可以) 在O(lg n) 內query 到 range 內的inversion總數, Editorial也是這樣說的, 但沒詳細解說怎樣做, 我在comment問了一下吃白果了
為此我還在Stack Overflow問了, 但是沒答案, 有人知道的煩請答一下

由於Peter神用approach 2 已經秒殺了這題, 我就認輸了
看了一下某些紅字User的code, 發現90%人都是用approach 2的
而另外10%人, 用了一種叫"Wavelet Matrix"的template, 我認為就是approach 1需要用到的data structure吧....話說也看到有人真的用很簡單的Segment Tree過了...沒深究下去了

果斷用approach 2試試做一下 (比賽中90%用的方法, 理論上應該要學習下思路的)
approach 2 是有 sqrt(n) 在內的...

關於這一點, 我早有感受: 我對 SQRT(N)相關的複雜度完全不敏感!
什麼RMQ, LCA好像也有SQRT(N)的存在...所以其實SQRT(N)也不是冷門的
也是要學習開始敏感了

暫時我的感覺是, 如果有關於 FACTOR / 除數 之類的題目, SQRT(N) 也可能有關係
(想想Prime Sieve的原理)

我comment中的2個case 是由於那個除數直接導出的結果, 令到總segment的數量只有
2*SQRT(N) = O(SQRT(N))
感覺上這樣分2個case歸納出SQRT(N)的手段可能很common, 記下比較好 (我是第一次見)

另外這題也是很有得著的!

首先就是一個可能頗常用的技巧
"Delta Encoding + Partial Sum"!! O(N)
Delta_encoding是第一次聽, 但做法不是第一次用了...這次更"學術"地看看這是什麼東東

簡單地說, 他是一個array, array中的每一格記下與上一格的difference
然後把這array 做partial sum, partial sum後每一格是原來的data array

例如 現在range [1,10] = {0}, 我做了幾個operations
1. [3,5] +1
2. [7,8] +1
3. [4,6] - 1
問現在range[1,10]的value?
這樣每個operation可以用Delta Encoding的手法以O(1) update一下:
[3,5]+1 --->  range[3]++; range[6]--;
[7,8]+1 --->  range[7]++; range[9]--;
[4,6]-1  ---> range[4]--; range[7]++;

現在range的array是 {0,0,1,-1,0,-1,2,0,-1,0}
然後以O(N)在這上面做 partial sum, 得出
{0,0,1,0,0,-1,1,1,0,0}
完全正確!

這樣代表什麼? 是代表其實可以用這方法取代BIT / Segment Tree嗎?
不!!
這個方法只能處理Static的operation, 不能online dynamice地update segment和query segment
是有點相像但卻完全不同的處理手法...

另外這個方法感覺上好像一定要配合partial sum才有用武之地?
所以"Delta Encoding + Partial Sum"是一個以O(N) Offline 處理range update operations的手法


另外學到的是 Floor() / Ceil() Properties!
這題用approach 2 的核心思路, 是在於由一個Floor() / Ceil() 的Property推算出一個連續的 k  range
這個推算如果不懂 Floor() / Ceil() Properties (如我一樣) 是很難的...
幸好賽後找到了一個不錯的 Reference! 


除了在這次Editorial 推算中出現的Property外, 還出現了很多年前忘了是Chin爺說的還是說的
"沒有precision lost的ceil 方法"! 就是:⌈​m​​n​​⌉=⌊​m​​n+m−1​​⌋


在coding中, 直接 (n+m-1)/m 就做到 ceil (n/m) 的效果了
Reference也很好的解釋了如何得出這條式的...!

所以這題就這樣了...
學習到的是
  1. 對SQRT(N)要更敏感一點
  2. Delta Encoding + Partial Sum的技巧
  3. Floor() / Ceil() 的Properties
話說我對Approach 1 (就是我原先的想法) 還是念念不忘, 要是有神人能用簡單的 BIT / Segment 做到 而不是用什麼 "Wavelet Matrix" 的話, 煩請告知一下!

PS: 希望下場CF 也是正分, 可以上黃色吧...

2015年3月15日 星期日

Codeforces Round #291 (Div. 2)

這場可真是我近來最想最想記下的一場, 記完這一場後真的要寫說好的Trie跟String Matching的Algorithm了...但在此之前  這場5題都做了
而且學到更多以前聽過卻沒學過的實用技巧!

Codeforces Round #291 (Div. 2)


A: (頹題, Greedy)
又一題改digit 令數字變成什麼什麼的題目...我又再重覆上一場的句子: 通常都是Greedy就行了..

B: (Math, Geometry)
略有一點難度的數學題, 問最少要多少條線才能把所有目標都擊破
也不用特別的技巧或用上大家比賽常用的Geom的Class, 只要計Slope, 一樣Slope 的就Lie on 同一條線了...

C: (String, Hashing)
第一題要詳細記下的題目!
這題跟之後會寫的String Searching不無關係!
先來說題意吧:  Given n 條pattern, 和m 條 string (每一條是一個獨立query),  所有string 只會由[a-c] 組成
問是否有任意一個pattern跟 string 只差exactly 一個字母相異?

在學了Trie的基本之後的我, 直接想到的也是用Trie 去解, 事實上看comment也有人說能用
prefix tree (即是Trie)去解...但當時我沒很直接想到怎樣做

String的處理我一向都很弱 (說真的也沒什麼特別強=.=)
我只想到 每個query 可以試住做以下的事:
  1. 每個位試試改成其它的2個字母   eg: 原本是'a'的話試試改成'b'或者'c', 每個位都這樣做
  2. 跟每個pattern比較一下看是否一樣
這題的時間我也很難分析, 因為它是直接說"所有input 的總長度 L<= 6*10^5"  
所以這樣說吧, 上面的第一步最壞的情況已經是O(L), 第2步要跟每個pattern比較一下這步卻很痛苦, 這是multi-pattern matching, 用KMP好像也不一定夠快? (我也忘了KMP怎寫, 只記得concept...) 實際上我也真的這樣implement, 也真的超時了

結果還是跑去看Editorial, 又掘到金了! 兩大keywords:

Rolling Hash,  Rabin-Karp Algorithm
 前者是一個運用Polynomial Hashing的一個技巧, 後者是活用這個技巧的 Multi-Pattern Matching Algorithm!!
這個Wiki 的解釋也真的很好懂, 沒複雜的分析, 但很有說服力, 而且還說明了它跟其它String Matching算法的分別, 例如它說了 "Rabin-Karp始終是Hashing, 可以有很差的效率, Single-Pattern Matching上還是KMP佔優, 但它的強處是在Multi-Pattern Matching (其它的還有AC自動機)"

所以...基本上這題就是Rabin-Karp Algorithm的變種囉
詳細的自己再看上面的wiki-page吧

Rolling Hash 是一個技巧, 不一定要 "減頭加尾", 像這題, "換一個字母" 這類的事當然也做到
只要你是用Polynomial Hashing就行了

我想這題最難的是要說服自己時間複雜度
官方說是 O(L lg n)  我感到有點奇, 因為我自己AC的版本, 最低限度也是O(L lg n) 但這沒算上Hashing Collision後要做String Comparison 然後fail 這件事
理論上Hashing Function柒的話, 這件事可以發生很多次吧? 那就遠超於 O(L lg n)了, 因為要做很多次String Comparison, 這也是為什麼它用在Single-Pattern Matching時worst case可以跟naive algorithm一樣是O(NM)的原因...不過算了AC了就好了, 也可以這樣想吧: 一直以來所有人都是用Polynomial Hashing去比賽的, 這已經是定式了, 自然不會是一個"柒"的hash function...

以某黃字User的comment做一個結語:
Most hashes are certainly not unique or why do we use hash? If C is in ACM/ICPC, you can simply choose a prime other than 3 because the problem setter does not know which prime you used so he can not construct data against you. He can only guess some contestants will choose 3 and build some data to make them failed. However, in Codeforces, hackers can construct data against a solution. So you have to compare two strings themselves when the hash of them are the same. However the probability of two different strings have same hash is low so only a few strings will be compared. So, the hash helped you to evade TLE.

強烈建議看一下Code, 也是很有機的寫了一些comment
http://codeforces.com/contest/514/submission/10158032

D: (Binary Search, Two-Pointer Algorithm, Segment Tree)
這題有點難搞
原因在於 題意其實很直觀, 就是不斷query 一個range maximum
所以我直接就用Segment Tree上了! 結果也是AC的
(原本有想過能否用BIT可以更易寫出來, 但maximum之類的好像不能用BIT做...只能做統計的工作啊)
http://codeforces.com/contest/514/submission/10172455

正如我的comment上所說,  這是overkill啊,
官方的答案是用一種叫 "Two-Pointer Algorithm" 的方法, 那個方法應用在這條題目上很高明
但實作上我自己是想不出來了, 紅字User們說是用兩個Stack的樣子
總之正解是易寫也很有效率

我反而學到了兩件事: 是否overkill也不要緊, 但起碼concept對, 寫得出來, 就可以AC的, 也不用這麼介意...
然後再來Google了一下什麼是Two-Pointer Algorithm...這東東很多題目都有Tag, 從來都沒認真想過是什麼的一類Algorithm

看了高手們的解說, 就比較清楚了:
這類Algorithm的運作通常是這樣的:
一個pointer指住第一格, 一個pointer 指住最後一格, 然後開始夾三文治
做某些東西或者checking, 然後移動其中一支pointer (不知會否有2支一起動的情況?)
一個pointer只能向單一方向移動, 而每次最少一定要移動其中一支pointer
這樣的話 時間性一定是O(N)了
這類Algorithm好像很強大的樣子, 形象化來想有點像什麼Sliding Window還是 Sweeping Line的? 傻傻搞不清, 總之這種思路還是記一下好

E: (DP, Matrix Repeat Squaring)
另一題很想記下的題目!
因為這道題的重點在於當年聽過的Matrix Repeat Squaring應用
話說當年完全不知 "為何, 何時, 怎樣" 用這個技巧
還是CF的高手們好, 一個Reference就解得清清楚楚的說

先說一下題意:
一棵無限的Tree, 每個node 都一樣有同一set的兒子 (最多有10^5個兒子)
eg:  root 有 3個兒子, 它的每個兒子也一樣有3個兒子....直到無限深度
每個兒子跟它的parent距離 (edge的長度) 最多是100
現在問有多少個node距離root 是 x ( x < 10^9)

這題很直接就能寫下DP的狀態:


dp(i) 為 有多少個node 距離現在的node EXACTLY = i

然後答案就是


但難度在於 dp(x) 的 x 可以有 10^9 那麼大! 即使是 O(N)也超時 (也超MEMORY!)
怎麼辦呢??? 原來....原來....
原來這種情況就是要用Matrix Multiplication的Trick啊
在Editorial 挖金挖到一篇超上乘的tutorial 給我這種新手的
Matrix Exponentiation

But, what will you do if the problem says, given 0 < n < 1000000000, find f(n) % 999983 ? No doubt dynamic programming will fail!
這是它的前言, 說了最簡單的DP例子Fibonacci Sequence, 在 n 好X大的時候也是會吃屎的
而這就是 "Matrix Repeat Squaring" 出場的時候了!
這種加速的技巧只能用於符合某種"形式"的 Recursion Formula, 也就是DP Transition
| f(n) | | f(n+1) |
| f(n-1) | | f(n) |
M x | f(n-2) | = | f(n-1) |
| ...... | | ...... |
| f(n-k) | |f(n-k+1)|
直接引用它的解說, 其實就是先寫下 類似以上的算式, 以他的notation
第一格就是我們想要的答案 而其它的是計算答案時要用上的東東
然後我們逆算出 M 這個 n*n 的matrix, 之後的就簡單了, 把repeat squaring的技巧用在
matrix multiplication 上算出 M^x, 乘上我們的"base case" (最開頭的 n*1 vector)
就能得出我們想要的答案 (右邊的n*1 vector, 的第一格)

例如 Fibonacci Sequence, F(n) 要用上F(n-1) 和F(n-2) 對吧
右邊先寫上 B
| F(N) |
| F(N-1)|

左邊是比它"前一步"的States, 我們叫它A: | F(N-1)|
| F(N-2)|

然後要做的就是人手逆推 M, 使 MA = B
| ? ? | |F(N-1)| | F(N) |
| ? ? | * |F(N-2)| = | F(N-1)|

不難推出 M 是
| 1 1 |
| 1 0 |

那麼當我們要算 F(10^9) 的時候 只要算 M^(10^9) * A , 然後得出的B 的第一格就是我們的 F(10^9)了!

其它詳細的看那個優美的Reference吧, 都說得很清楚了, 通常M 都會很有Pattern 不需要hard code就能generate出來的
由於 是做 lg(x) 次 matrix multiplication, 假設matrix 是 N*N
那麼就是 O(N^3 * lg(x))
很好很強大的DP輔助技巧!

回到原題目上, 基本就是用這個想法, 當然作為Problem E也沒這麼直接
最不同的是我們要求的答案不是單一的 DP(X) , 而是 summation DP(i)
但也是大同小異的

首先注意到我們的A (也就Base Case的vector) 要用上全部DP(100) 個State
所以 X <= 100的時候, 直接用普通的DP就好了
當X > 100的話, 我們就要用上這個技巧了
注意先Update X = X-100, 因為現在我們的"Base"不是 0, 而是100
然後由於我們想要算的是 summation DP(i) 那麼乾脆把它放進我們的A (還有B) 內 加上本來的 DP(1) to DP(100) 總共是一個
101 * 1 的vector


官方的notation是 1* 101的, 思路一樣, 我想我以後還是會跟Reference那個notation

接下來的就是逆推 M了, 這一步是這一題的唯一難度 M 是什麼可以自己看Editorial:
(注意它跟我 / Reference的notation不同, 應該是Transpose了還是怎的)

就是這樣了! 
最後把AC的Code貼一下以作記念: comment應該也算清楚的 日後重溫應該也明白的吧...
http://codeforces.com/contest/514/submission/10218534

2015年3月5日 星期四

2015 Facebook Hacker Cup, Round 1

說好的Facebook Hacker Cup 2015, 終於有空寫了
事實上在前幾天才做完四題...
FB的比賽很不好地沒有practice mode 幸好偉大的CF以Gym的形式提供了練習途徑
Gym在沒有AC前不能看Test Cases 和 別人的Code就是了...

這場比賽有4道題目, 難度我覺得是CF 較難一點的Div. 2 吧..?
比賽使用計分制, 實際執行時間也有幾分鐘, 這是我一直在想的問題
因為大部分比賽只用1秒, 算法也比較易逆推出來
數分鐘的話反而很混亂, 好像什麼 "不正常" 的算法也有機會是官方的答案...

即場我只做了2題, 而規則上所有跟第500名同分的人都可以去Round 2
沒想到遠超過500人4題全對了...
我交的2題也只AC了1題, 另一題錯了一個白痴的exceptional case...唉!!

還有另一題沒有做的, 其實不是難做, 是語癌的問題, 直到現在我也搞不清楚是我英文差還是什麼原因, 總之完全不明白題目的意思, 跟Test Case怎樣理解也有點矛盾, 即使AC了也是半合理地
推斷"題目是這個意思"...這個有多少生氣跟遺憾

最後一題則是看了答案後更加知道沒有抵賴的餘地, 現場是怎樣都不會做到的, 主要原因是...算法是想到了, 倒是算法的parameter limit 我完全沒有頭緒, 暴試的話怎樣也會超時...
所以即場我是"打倒自己", 感覺那個算法是錯的, 有其它方法....原來方法是對的, 倒是有聰明的想法證明parameter limit很小...

2015 Facebook Hacker Cup, Round 1


題目: http://codeforces.com/gym/100579/attachments


A: (Math)

Given range [A,B],  B<=10^7,  問有多少數的primacity = K,  K<= 10^9
primacity的定義是 # of distinct prime factors

這題算很易了...就是改一下Prime Sieve (就普通的Prime Sieve, 不用前文所說的Linear Sieve)
每次刪去合成數時把該合成數++,  代表這個合成數又多一個prime factor了
是我唯一現場AC了的題目...

void make(){
    p[0] = p[1] = 1;
    for(int i=2; i<10000005; i++){
        if(!p[i]){
            for(int j=i; j<10000005; j+=i){
                p[j]++;
            }
        }
    }
}

B: (String, Trie, STL)

正是我說的語癌題!!!
其實看時已經知道是用Trie / 字典之類的方法做了, 數據量問題不太肯定能不能用STL做
事後知道是OK的, 但我也說了想借此機會也應用一下Trie, 就用Trie做了
這題沒難度的...只要理解了題目的話!!!

題目大意是: 給定一堆字, 現在想把它把儲進電話內做autocomplete.  那麼當然是打該字的prefix就ok了, 然後問最少total打多少字....重點的一句是這樣的: The prefix must either be the whole word, or a prefix which is not a prefix of any other word yet in the dictionary.

媽啊, 你UP咩春呀...
最開頭也直接的想法是: 啊, 當第某一個prefix已經儲進去了, 之後就不能再以同樣的prefix代表這個字了
這樣的解釋連第一個test case也過不了, 因為要是這樣, 第4個字的prefix就是 "hi" 不是"hil"

那麼...是不能跟已經儲進去的prefix所代表的那個字一樣嗎? 然後 either be a whole word 又是怎樣, 是說整個字都是另一個字的prefix要特別處理嗎??

靠, 怎樣想也不能同時滿足所有test case, 尢其第3個

而這樣導致的結果是, 我知道是用Trie做也無從入手....語文能力是多麼重要啊...

好吧, 開估吧, 以下是正確的題目意思:
每次加一個字進字典時, 盡量加最短的prefix, 但這個prefix 不能是前面其它字的prefix!

所以sample test case 1 第4個字不能入"hi"! 因為第1個字已經是"hi", 即使第一個字儲進電話的prefix是"h"而已也不行!

然後test case 3 答案是11 並不是我原本想的 "4+3+2+1+1"...而是"1+4+3+2+1"!!!
解釋是第一個字當然就入一個字母的prefix "a",  然後第2個字, 不論怎樣切都是第一個字"aaaaa"的prefix, 所以就只能以"whole word", 也就是"aaaa"這樣加進電話...之後的字也一樣


他媽的, 明白題目是這樣之後就是直接應用Trie了...我也知道我第一次寫Trie
但的確是直接用而已...你媽的語癌題目

有關Trie的理解跟應用 (以及其它String Matching的Algorithm) 我打算另開一篇詳寫, 因為近來很巧的做了兩場CF也有兩題題目學到新東西了...

這題一句, 用Trie! 每次加字就一個個字母插進去...一發現還沒生成該node 就是前面沒有相同的prefix了...采用之!

另外如之前說的, 這題用STL的Map 好像也行, 其實重點還是題目的理解啦...

C: (DP, Combinatorics)

第二題即場有交的題目...而且是"正確"的!!!
我只是沒有處理一個特殊的Base Case而已...而且那個Base Case也是反直覺得很嘛...
老實說Download完input file後我也有特別留意這個Case, 反而我是認為我的output對才提交的呢...

題目有點複雜, 給了一個體育比賽的完結分數, 例如 3-1
代表第一隊以3分勝出, 第二隊拿了1分, 就輸了

然後定義一種叫"無壓力勝出", 是說勝出的隊先拿了第1分, 然後一直到完結它的分也比另一隊高!
另一種叫"無限壓力勝出", 是說勝出者直到敗者達到它的完結分數之前, 一直也比敗者隊低分!

問題是數出有多少種不同的組合可以"無壓力勝出" 及 "無限壓力勝出"?

簡單來說, DP, 而且是2個DP, 2個互相很像, 沒有交集
無壓力勝出較易數的, 另一個因為敗者到達結果分數後你可以反超前, 較難數, 但也大同小異

詳細就不寫了, 也不太記得了, 直接貼Code...
而我中的伏是...是...是敗者0分的情況..? 好像是...不太記得了
總之是一開始敗者已經到達完結分數, 這樣的情況下組合只有1, 而我的DP出0了...
真的只差這一個Case, AC與WA之差....!!!!!!!


  dp[1][1] = dp2[1][1] = 1;
    for(int i=2; i<=a+b; i++)
        for(int j=1; j <= a; j++){
            dp[i][j] = dp[i-1][j-1];
            if(2*j > i) dp[i][j] = (dp[i][j] + dp[i-1][j])%C; //無壓力勝出
        }

    for(int i=2; i<=a+b; i++)
        for(int j=1; j<=b;j++){
            dp2[i][j] = dp2[i-1][j-1];  // 有壓力勝出
            if(2*j >= i || j == b) dp2[i][j] = (dp2[i][j] + dp2[i-1][j])%C;
        }
    printf("%I64d %I64d\n", dp[a+b][a], !dp2[a+b][b]? 1: dp2[a+b][b]); //特別處理中伏CASE


D: (DP, Graph)

最後的一條好題目...
只能說我輸了

題目很簡單的, 給了一棵Tree, size N <= 200,000
要color這棵樹, 但每個node不能與它的parent一樣color
color 由 1開始到 N, 無限量使用, color i 花費 $i , 問total 最少多少錢才能完成coloring?

當時還沒學到Bipartite Matching, 但當然現在直接就會想到, 2-coloring吧?
但很明顯沒這麼簡單的...

看官方FB的Solution, 2-coloring不一定是最好的吧...

這種Tree的題目, 很易想到DP去, 但先慢慢想一下
最初想的, 會否有Greedy的水分在內... (因為是Round 1...這個心態真的要改, 害死我很多次)
Greedy來說, 會否由根一直把能填最小的都填, 又或者由葉一直填上根?
很可惜的 我自己也找到一堆反例子

在一直寫反例子的途中, 有個感覺, 就是可能會使用到的color數目不會太多...但證實不了
結果這就是問題的重點...我當時想到的是, 既然Greedy好像不行, 只能DP了

設DP(x, c) 為 node x 使用 color c 時, 以它為根的subtree 的minimum cost
問題是c 實在可以太大了,  可以到N 啊...
那時我的確沒想到, 也想不到, 如果 c 很小, 其實問題就解決了...
也就是說...!
這個DP是正解, 讓我來貼一下CF高手們的答案


也沒什麼好解釋的, 有點self explain, 感覺就一定對的了....
所以這題最後一題的難度是在證明 c 很小啦!!!!

官人來看, 小的找到兩個不同的方法去證明...一個簡單易明但有點出cheat的, 另一個是官方FB的嚴謹數學證明!

先來看簡單易明的Version:

由某CF高手提出,  我們想要證明的是 會用到的不同color種類很少, 這個數字跟Tree Size N 有關係。
有點逆向思路, 來定義一個function C(x):=  Root node一定要使用color x的話, 達成的minimum cost 的Tree的minimum size.  有點語癌, 其實不難明, 看頭幾個數字:

C(1) = 1, 代表的是只有一個node的Tree, 它能達成最minimum cost就是1, 也是我們的x
C(2) = 2 對嗎? 因為 root 使用 2, 它的獨生子用 1....很可惜這是錯的
C(2) = 3 才對!! 因為我們希望這是唯一的樹, 它是最小的, cost也是最低的, 然後root 一定要使用 2, 所以就是 root使用2, 兩個兒子用1,  這3個node的color怎樣變也不會比這個填法更優
而如果只有獨生子, 則那個樹不是唯一的, 因為也可以root 用1, 獨生子用2, 同一個size, 同一個cost, 但root 可以不使用 x=2 為color

C(3) 開始複雜了, 直接套用該高手的話:
root要是3的話,  它最少有3個color 是1的兒子, 不然可以把全部color 1 的孩子(最多2個) 變為 2, root改為 1, 導成相同的cost相同的size...
同樣道理, 它最少有 2個 color 是2的兒子
那麼C(3) 最少是 1 + 3*C(1) + 2*C(2)  = 10

小總結, C(1) = 1, C(2) = 3, C(3) = 10....怎樣, 有點Pattern / Sequence的感覺吧??
然後高手說, 把這個數字去OEIS找一下, BOMB! 出現鳥!
Number of order-consecutive partitions of n

1, 3, 10, 34, 116, 396, 1352, 4616, 15760, 53808, 183712, 627232....

這個當年KN介紹的神網想不到在這兒能夠用上...
那麼廢話就不多說了吧...實際上 c 去到 ~11-12, 最小的樹已經超過200,000個nodes...
也就是說我們的DP是可行的, 也就 O(N*c)而已!
下面是FB官方的數學方法:
We can also prove that O(log N) is an upper bound for C. Let C(k) be the size of the smallest tree that needs all colors 1, 2, ..., k in an optimal coloring. Trivially, it holds that C(1) = 1 and C(2) = 2. Without loss of generality, we can pick the node with color k to be the root. In that case, the root needs to be adjacent to all colors from 1 to k-1 and we can apply the inductive hypothesis as follows: 

C(k) ≥ C(k-1) + ... + C(2) + C(1) + 1 ≥ 2k - 1 + ... + 21 + 2 + 1 = 2k

這...這個是傳說中的M.I. 啊...思路是直接猜想 c ~ O(lg N), 逆向只要證明到上面那句statement就ok了...我說我真的不能即場就有這麼嚴格的證明啊..

CF另一些高手的思路想像, 卻更像是比賽中可以學習使用的想法:
I think there is: a[1] = 1
a[x] = 1 + 2 * (a[x - 1] + a[x - 2] + ... + a[2] + a[1])
At least 2 v values must appear in children. If there is only one v < x value, you can swap it with root and you have v in root.
So a[x] = 3x - 1 I assumed second y <  = 13. 

思路是一樣的, 也是很roughly地寫出 color = x 的root 下面最少要用多少個兒子
然後不用直接找lower bound, 但upper bound已經是 O(lg N) 了....這個思路也真的要學習下

順帶一提, FB官方也有說到這題有O(N)的解法, 解法很巧妙, 我不知怎樣實現就是了
大約就是不用把10多個color暴試, 只要試"最好"的2個color就好了
然後precompute 最少要給多少錢, 然後看看那些node要將就使用"第二好"的color 就把它加上那一個offset...詳細自己看官方答案: https://www.facebook.com/notes/1047761065239794/
我是不知道怎樣找出"最好"的2個color就是了...


來個小總結, 這是一場學到很多東西的比賽, 而且只是Round 1, 了解到自己實力很不足啊
以前的話應該會很不開心吧, 現在好像沒那麼介意了, 還有點小開心可以繼續進步學習挑戰, 我想我是瘋了 0.0